コラム
AI攻撃の自動化で増えるセキュリティ事故と、APIの脆弱性診断
- 脆弱性診断
- APIセキュリティ
- 認証・認可
直近、国内では多数のハッキング事件や情報流出が相次いで公表されています。弊社が国内組織の公表情報を独自に調べたところ、2026年9月2日から10月9日までに確認したセキュリティ事案は155件で、1日平均で約4.1件にのぼります※1。
なぜ、情報流出が増えているのか?AIを利用した自動攻撃なのか
情報流出が相次ぐ背景の一つとして、AIを利用した攻撃の自動化が考えられます。AIエージェントは、攻撃対象を探し、弱点を試し、結果に応じて次の手を考える作業を連続して進められるためです。
LLM(大規模言語モデル)は、文章や画面の情報だけでなく、サイトの構造も読み取れます。ページのつながりや入力フォーム、画面の裏で呼び出されるAPIを読み取り、脆弱性がありそうな箇所を探索して、そこを攻撃します。これをエージェントの仕組みと組み合わせると、ブラウザーや各種ツールを動かしながら、探索と攻撃のサイクルを自律的に回せます。攻撃の結果を見て次の探索へ進めるため、ある種、無限に攻撃を続けられることになります。
Anthropicが公表した事例では、攻撃者がAIエージェントを使い、約30の組織を標的にしたとされています。同社の説明では、AIが偵察や脆弱性の確認など攻撃キャンペーンの作業の80〜90%を担い、人間は数回の重要な判断点で介入しました※2。これはAIが人間の関与なしに無制限に攻撃したという報告ではありません。しかし、調査と試行の多くをエージェントに任せ、人間が節目を判断する運用が現実に行われた例です。
このようなエージェントは、一般論として、次のような調査の流れをつなげられます。
- 1. サイトを巡回する。公開ページや画面の情報を読み、利用できる機能を把握します。
- 2. 弱点の可能性を見つける。画面や応答から、認証や権限の確認が不十分かもしれない箇所を推測します。
- 3. 結果を見て次の確認を選ぶ。想定と異なる応答があれば、別の条件で調べるなど、結果に応じて作業を続けます。
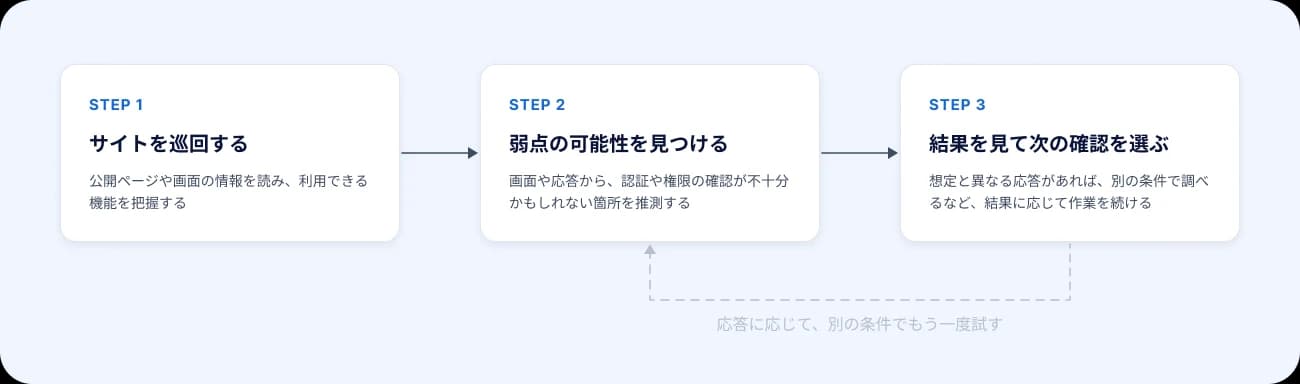
この流れは、許可を得て行うセキュリティ診断でも使われる調査の考え方と重なります。攻撃者が同様の仕組みを多くのサービスに向けて動かせば、人が一件ずつ調べていたときよりも、対象や試行の数が増える可能性があります。
ただし、今回集計した国内事案で、この手順がAIにより実行されたと確認されたわけではありません。また、エージェントが常に正しく判断するわけでもなく、誤った情報を事実のように扱うことがあります。Anthropicの報告でも、AIが誤った認証情報や公開情報を盗み出したと誤認した例が記されています※2。
攻撃者が、カスタマイズしたモデルを利用できる
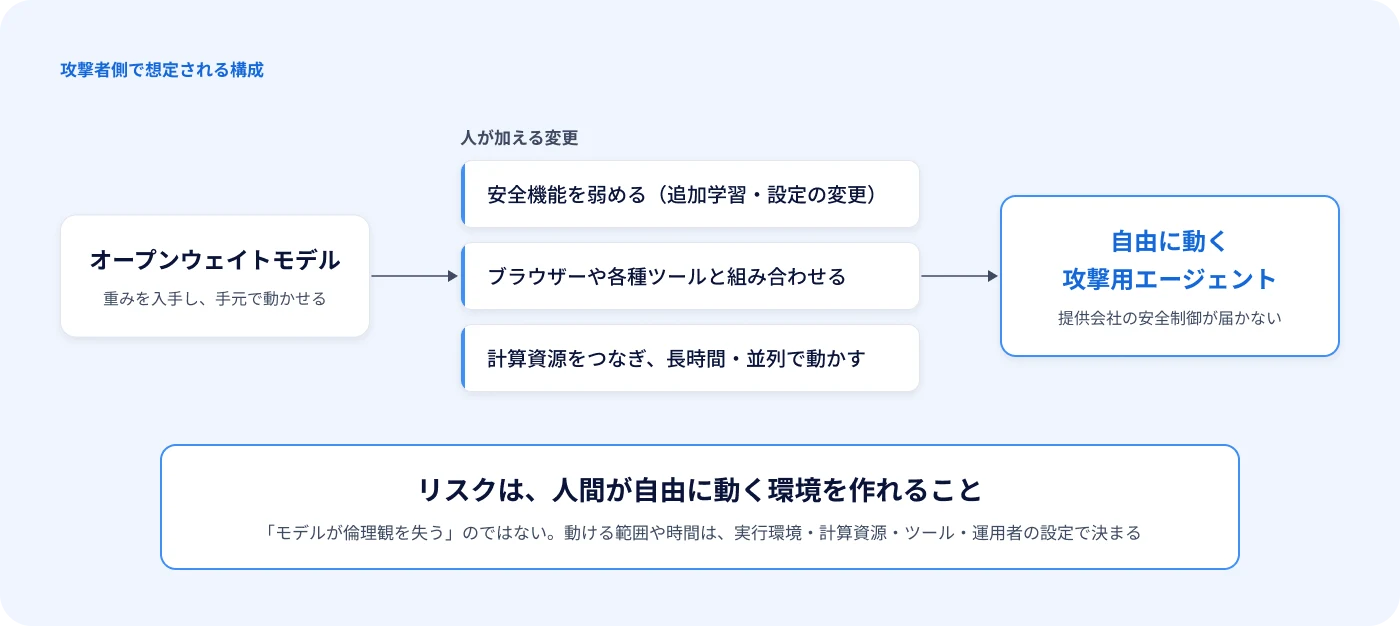
攻撃者が利用できるAIモデルも変化しています。提供会社のサービスを通じて使うモデルとは異なり、オープンウェイトモデルは自分でダウンロードし、改変して利用できます。追加学習をしたり、安全機能を変更したりすることもできます。
Anthropicは2026年、オープンウェイトモデルのGLM-5.3を隔離された環境で評価しました。有害な依頼を断る安全機能を外したコピーを作ったところ、拒否する割合は9割超から数%まで下がり、性能はほぼ保たれました。そのうえで、既知の脆弱性を突く攻撃コードを作る課題などで、同社の最先端モデルに近い攻撃能力を確認したと報告しています※3。
つまり、誰でも入手できるモデルから、強力な攻撃用のモデルを作れるということです。提供会社のサービス上の安全制御は、手元で改変されたモデルには届きません。計算資源を投下すれば、こうしたモデルを24時間365日動かし続け、休まず攻撃させることもできます。なお、これはベンダー自身による能力評価であり、GLM-5.3が現実の国内事案で使われた証拠ではありません。
24時間の攻撃が当たり前になるのか
これまでの攻撃は、人間が判断しながら一件ずつ調べ、次の行動を決めていました。エージェントは、ある種自律的に、際限なく探索を続け、結果を見て次のアクションを決められます。攻撃者が複数のエージェントを並列に動かし、計算資源を投下して稼働させ続ければ、睡眠や休憩、勤務時間といった人間的な制約を受けなくなります。
防御する側は、夜間や休日も含めて、攻撃が24時間止まらずに続く前提で備える必要があります。モデルの誤りや防御側の検知・遮断もあるため、すべての試行が成功するわけではありません。それでも弊社は、攻撃対象を探す活動や攻撃の試行が、今後さらに増える可能性が高いと見ています。
セキュリティ対応を最優先に、AIで点検し続ける
攻撃が24時間止まらずに続くなら、守る側もセキュリティ対応を最優先に置く必要があります。
これまでのように年に1回脆弱性診断を受けるだけでは、次の診断までの間に弱点を突かれかねません。機能やAPIを追加・変更するたびに逐次点検し、対策をアップデートし続ける必要があります。それも一度やって終わりではなく、継続的に行います。
また、画面を少し変えたり、人が手作業でテストしたりするだけでは、自律的に動く攻撃に追いつけません。守る側も今のAI技術を使い、自律的に攻撃へ対応します。エージェントが自社サービスを攻撃者と同じ視点で調べ、見つかった弱点を優先度に沿って修正し、修正後に再診断する。この流れを止めずに回し続けます。
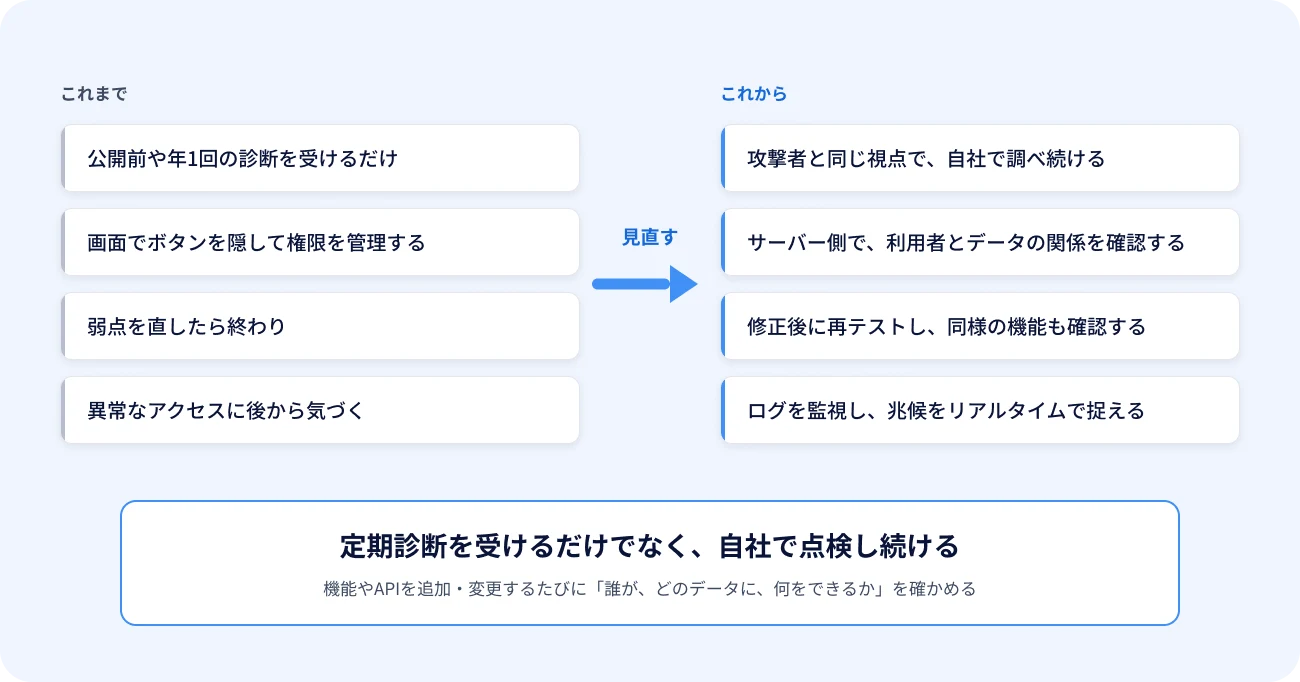
点検の軸は「誰が、どのデータに、何をできるか」です。意図したアクセスだけができることを確かめ、同様の機能に同じ問題がないかもあわせて確認します。
特に、画面でボタンを隠すだけでは権限管理になりません。APIへ直接アクセスされても、サーバー側で利用者と対象データの関係を確認しなければなりません。OWASPの認可テスト資料も、機能、利用者の役割、データ単位で権限を定め、変更後に検査する方法を勧めています※4。
リアルタイムで攻撃の兆候を捉える
予防の点検と並行して、サービスのログを監視し、異常なアクセスを早く見つける仕組みを整えます。たとえば、短時間の認証失敗の急増、同じアカウントからの大量のAPI呼び出し、通常と異なるデータ参照が続いた場合に、担当者へ通知できるようにします。
兆候を検知したら、状況に応じてアクセスを一時制限し、認証情報の無効化や影響範囲の確認、ログの保全を行います。攻撃者の通信が通常利用に似る場合もあり、監視だけですべての攻撃を見つけられるわけではありません。サーバー側の認証・認可、アクセス制限、継続的な診断と組み合わせて対応します。
まとめ
- AIの進化とともに、直近で情報流出が異常に増えている。
弊社の調査では、2026年9月2日から10月9日までに確認した事案は155件、1日平均で約4.1件でした。背景には、LLMを使った自動攻撃の可能性があります。なお、同一事案を複数組織が公表した場合を含むため、攻撃の実数とは分けて読みます。 - 攻撃側はAIモデルを自由に改変でき、特化したモデルが自律的に動いている可能性がある。
オープンウェイトモデルは追加学習や安全機能の変更ができ、Anthropicの評価でも安全機能を外したモデルが高い攻撃能力を示しました。攻撃に特化したモデルが、より自律的に攻撃を続けている可能性があります。ただし、国内の個別事案でAIの利用が確認されたわけではありません。 - 24時間365日の攻撃に、年1回の対応では限界がある。
防御側も、よりリアルタイムに防御を制御する必要があります。AIを使って自社サービスを点検し、弱点の修正と再診断を自動で回すなど、守りそのものを継続的にアップデートしていきます。
弊社のマルゴト DXセキュリティでは、WebアプリやAPIの脆弱性診断(認証・認可、画面側のコードの確認)から、修正・再診断までを支援しています。何から点検すればよいか分からない場合は、無料相談からお問い合わせください。
出典・調査方法
※1 弊社独自調査。2026年9月2日から10月9日までに国内組織が公表したセキュリティ事案を集計。被害の可能性が公表された事案を含み、同一事案を複数組織が公表した場合も別々に計上しています。
※2 Anthropic, “Disrupting an AI-orchestrated cyber espionage campaign”(2025年11月)
※3 Anthropic, “GLM-5.3 and the spread of advanced cyber capabilities”。オープンウェイトモデルの能力評価。テストは隔離環境で実施されています。
ライター
小林昌太郎 / フィード株式会社 代表取締役CEO
新卒で富士通Japanに入社し、自治体向けのシステム導入と自社プロダクト開発を担当。コインチェックで金融基盤・金融犯罪対策システムの開発、ストックマークで自然言語処理プロダクトのリードエンジニア、グラファーで生成AIプラットフォーム等の新規事業開発に従事したのち、フィード株式会社を創業。
サービスのAPIや権限設定を点検しませんか?
公開中のWebサービスや業務アプリについて、API、認証・認可、画面側のコードを脆弱性診断し、優先して直す箇所の修正から再診断までを支援します。どこから見ればよいか分からない場合も、お気軽にお問い合わせください。